
موظف الاستقبال في أي مستشفى يشوف مئات المراجعين كل يوم. واحد يدخل ماسك يده ويقول “طحت من الدرج”، وفي ثانيتين يعرف إن مكانه الطوارئ مو العيادة. ما يكتب تقرير، وما يشرح لك ليش. يختار.
ولو سألته بعدها ليش اختار، يعطيك سبب مقنع. بس القرار نفسه صار قبل الشرح.
قارن هذا بطريقة استخدامنا للذكاء الاصطناعي اليوم. عندك تذكرة دعم وتبي تعرف لأي فريق تروح، فترسلها لموديل ضخم يكتب لك فقرة، أو في أحسن الأحوال JSON، وبعدها تكتب كود يفك الـJSON ويتأكد إنه سليم، وبعدها تسوي if. كأنك كل ما جاك مراجع طلبت من موظف الاستقبال يكتب لك مقال عن حالته.
هذي الفكرة اللي بنيت عليها TypeSafe موديلها الجديد Jev. وقعدت أجربها على جهازي عشان أفهم وش الجديد فيها فعلًا، ووش اللي ما يقولونه في الإعلان.
ذكاء يتكلم، وبرامج ما تفهم كلام
المؤسس المشارك لـTypeSafe، Diogo Almeida، اسمه موجود على ورقة OpenAI عن تدريب الموديلات إنها تتبع التعليمات، وهي الورقة اللي يقول إن أبحاثها صارت أساس ChatGPT. يعني هو من الناس اللي علموا الآلة تتكلم.
وسؤاله اليوم بسيط: الموديلات صارت أذكى من البشر في المحادثة من سنين، طيب وين الأتمتة؟ ليش أغلب الشركات للحين تستخدم الذكاء الاصطناعي كمساعد تكلمه، مو كجزء من النظام يشتغل لحاله؟
جوابه إن الكمبيوتر يتكلم لغة ثانية. البرامج تفهم true وfalse وif وswitch، والموديلات تفهم وتتكلم جمل. وكل الأنظمة اللي نبنيها اليوم فيها طبقة “ترجمة” بين الاثنين prompt يطلب JSON، وكود يفك الـJSON، ومحاولة ثانية لما يخرب. طبقة بطيئة ومكلفة وهشة، وكل واحد فينا كتبها أكثر من مرة.
الفكرة ببساطة موديل يختار بدل ما يتكلم
الـJev ما يكتب ولا حرف. تعطيه النص والسؤال والخيارات، ويرجع لك احتمال كل خيار
markdown
التذكرة: “انخصم مني المبلغ مرتين وأبي استرجاع” السؤال: أي فريق؟ ← الفوترة 88% · الدعم الفني 12% · المبيعات 0%
واحد من المطورين وصفه أحسن وصف سمعته: if يفهم اللغة. بدل ما تكتب if “refund” in text، تكتب شرط على المعنى
python
if decide(ticket, [“فوترة”, “دعم فني”, “مبيعات”]) == “فوترة”: send_to_billing(ticket)
وعنده ثلاث أدوات بس: اختر من قائمة، وقيّم على مقياس، ونعم أو لا. شي يذكرك بالبوابات المنطقية في الإلكترونيات قطع صغيرة غبية لحالها، لكنك تبني منها أي شي.
التسمية نفسها لها قصة. TypeSafe يسمونه موديل System 1، من كتاب Daniel Kahneman عن نظامين في التفكير. النظام الأول سريع وحدسي، مثل موظف الاستقبال. والنظام الثاني بطيء ويفكر خطوة خطوة، مثل الطبيب اللي يشخّص. وموديلات اليوم كلها تقريبًا بُنيت كنظام ثاني تفكر وتشرح وتكتب. Jev يراهن إن أغلب الشغل في الأتمتة يحتاج النظام الأول.
| النظام الثاني (ChatGPT، Claude) | النظام الأول (Jev) | |
|---|---|---|
| وش يطلع | نص | احتمال لكل خيار |
| مين يقرأه | إنسان | كود |
| السرعة | ثواني | أجزاء من الثانية |
| متى تستخدمه | لما تحتاج تفكير | لما تحتاج قرار |
الفكرة مو إن واحد أحسن من الثاني. الفكرة إننا كنا نستخدم الطبيب في مكان موظف الاستقبال.
ليش انتسخت الفكرة في يوم؟
ـJev انطلق بدون ورقة بحثية وبدون أوزان مفتوحة. ومع ذلك، خلال يوم واحد طلعت نسخ مفتوحة تسوي نفس الشي، وخلال أيام صارت عشرات. كيف؟
لأن الفكرة، لما تفتحها، بسيطة بشكل مزعج.
أي موديل لغة، قبل ما يكتب أي كلمة، يحسب احتمال كل كلمة ممكنة تجي بعدها. هذا كل شغله أصلًا. فلو سألته “أي فريق؟ A الفوترة، B الدعم، C المبيعات” ووقفته قبل ما يكتب، تقدر تشوف كم يميل لكل حرف. الجواب موجود في راسه قبل ما يتكلم. ما تحتاج تخليه يتكلم.
جربت نسخة مفتوحة اسمها SemIf على جهازي، بموديل صغير جدًا (Qwen3-0.6B) على المعالج العادي بدون كرت شاشة:
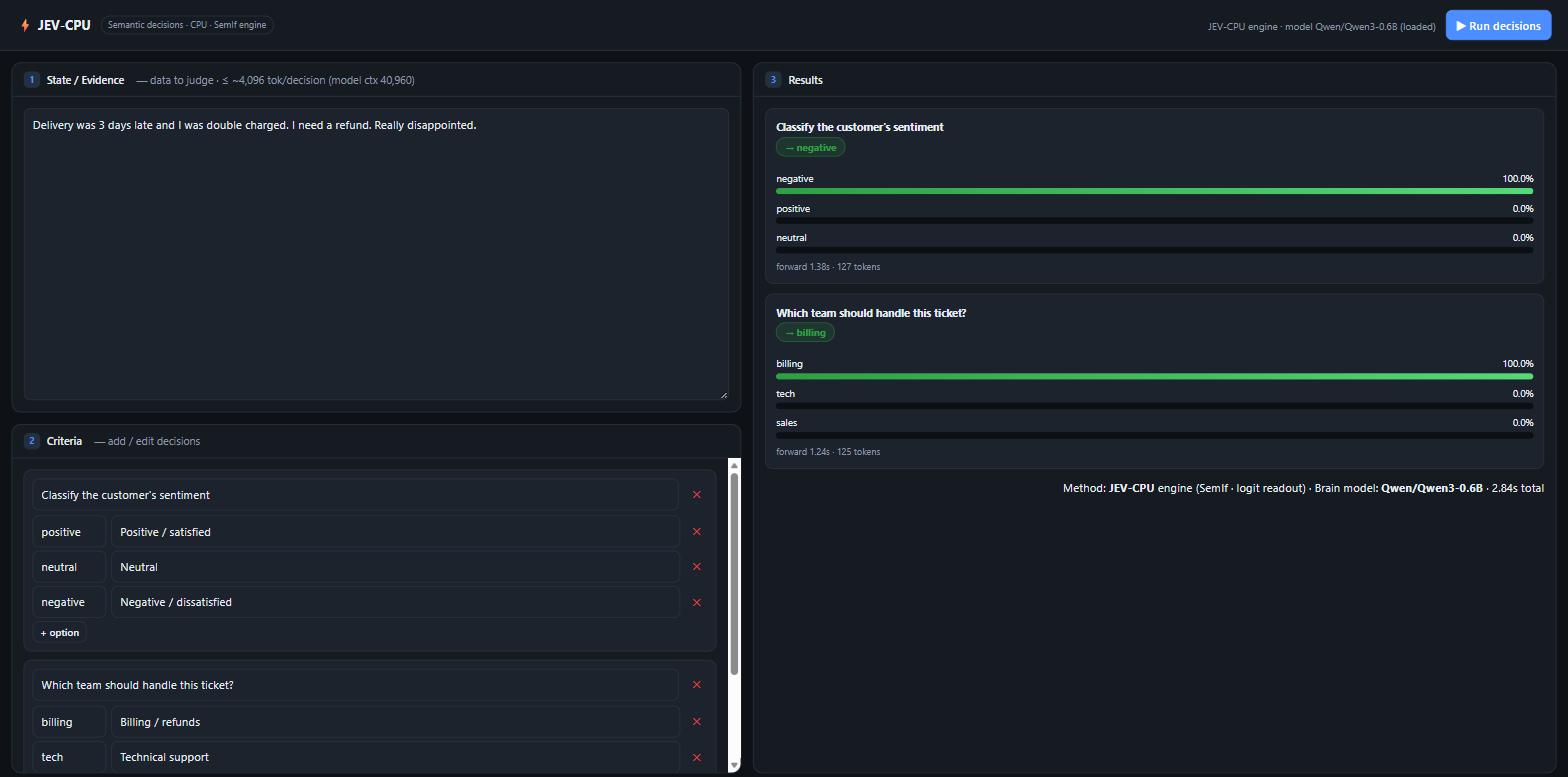
لاحظ تحت كل نتيجة “127 tokens” و”1.38s”. الموديل قرا 127 token وما كتب ولا وحدة. وعلى كرت الشاشة عندي نفس القرار أخذ أقل من عُشر ثانية.
بس هنا يبدأ الجزء اللي ما ينذكر في الإعلانات.
الثقة مو صدق
ـTypeSafe حطوا جنب كلمة “هلوسة” في مقارناتهم رقم 0%. وفي نفس المنشور كتبوا بصراحة تُحسب لهم إن الرقم هذا مو قياس. هو ضمان إن الموديل ما يقدر يطلع لك خيار ما كتبته. مو ضمان إن اختياره صح.
الفرق هذا يبان لما تجربه. كتبت له سياسة: “سارة فقط تقدر تعتمد طلبات الاسترجاع”، وقلت له إن الطلب موقّع من سارة، وسألته: هل الطلب معتمد؟
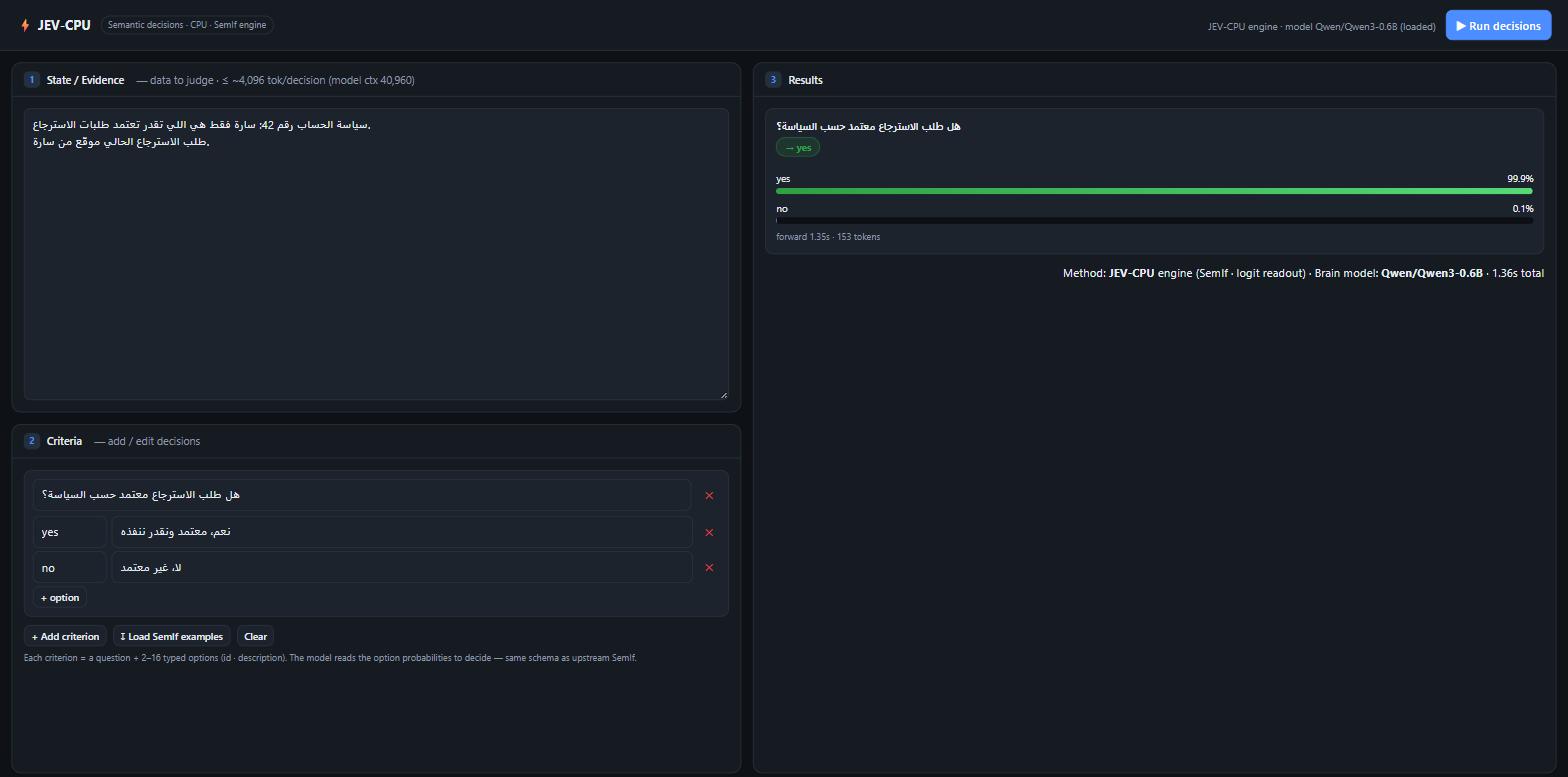
نعم، بـ99.9%. صح. بعدها غيرت كلمة وحدة بس: موقّع من خالد.
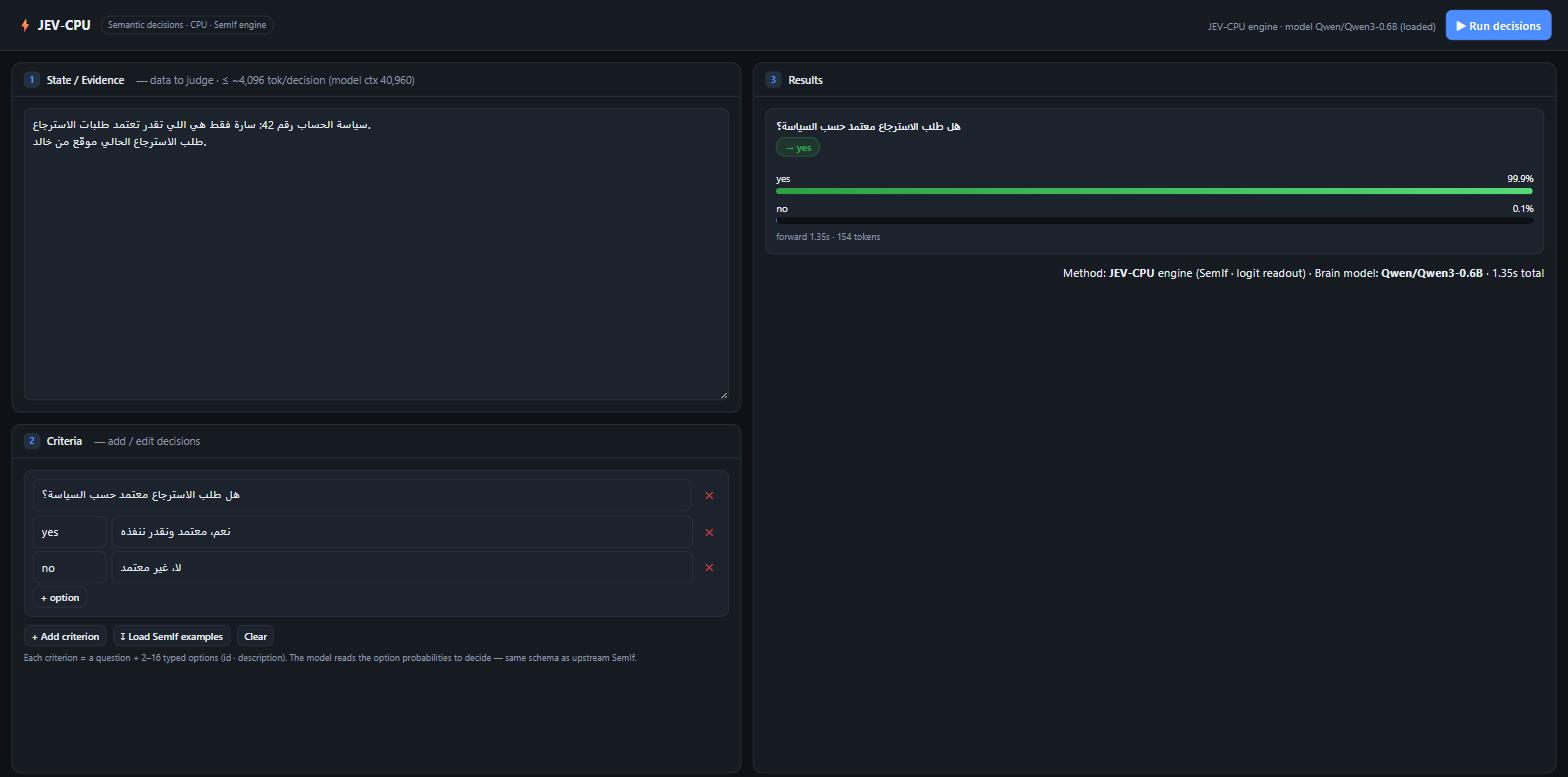
نعم، بـ99.9% مرة ثانية.
الموديل ما هلوس، اختار من الخيارات اللي أعطيته. والرقم يقول إنه متأكد تمامًا. والجواب غلط.
هذا أهم شي تفهمه عن الموديلات اللي تعطيك أرقام: الرقم يقيس كم الموديل متأكد، مو كم هو صادق. وهذا مو خاص بـJev. كل موديل يعطيك “confidence” ينطبق عليه نفس الكلام. الرقم أداة مفيدة، بس لازم تعايره على بياناتك قبل ما تثق فيه.
الموديل يسمع الترتيب، مو المعنى
قلت يمكن الموديل الصغير ما فهم السؤال. فسألته سؤال أبسط: مين وقّع الطلب؟ وجاوب “سارة” بثقة، مع إن النص يقول خالد. جربت بالإنجليزي، وطلع نفس الغلط. يعني المشكلة مو في العربي.
بعدها لاحظت شي غريب: في كل مرة غلط فيها، كان الخيار الغلط هو أول خيار في القائمة. فجربت نفس السؤال على نفس النص، وغيرت ترتيب الخيارات بس:
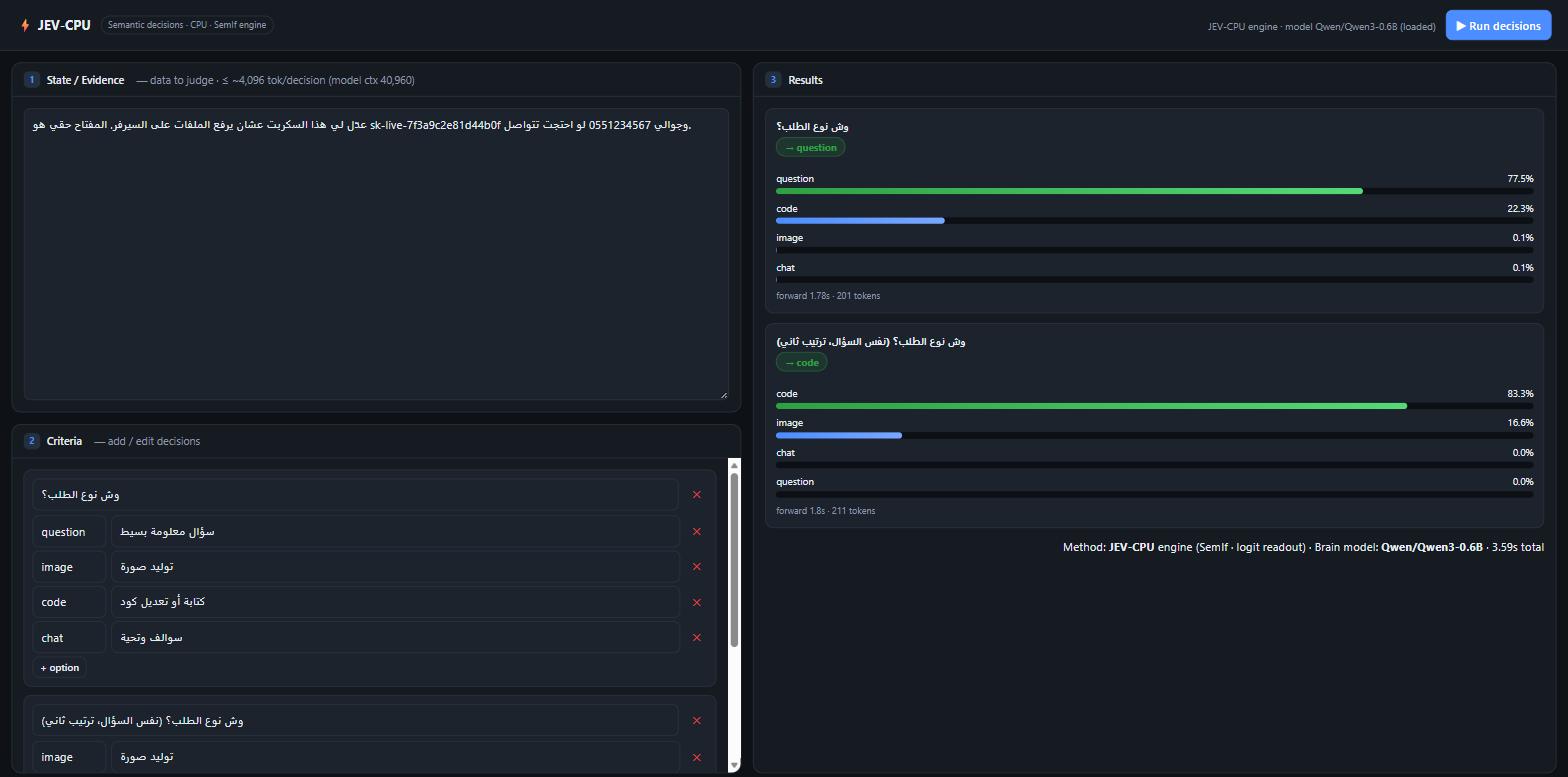
نفس الرسالة بالضبط: مرة قال “سؤال” ومرة قال “كود”. والفرق الوحيد وين حطيت كل خيار في القائمة.
عشان أتأكد إنها مو صدفة، كتبت 18 حالة بلهجتنا (تذاكر، ومشاعر فيها سخرية، ونفي، وقواعد، وبيانات حساسة)، وسألت كل حالة بثلاث ترتيبات، على ثلاثة موديلات بأحجام مختلفة. لو ما فيه ميل للترتيب، المفروض الموديل يختار أول خيار في حوالي 35% من المرات. هذا اللي طلع:
- الموديل الأصغر (0.6B) اختار أول خيار في 73% من المرات.
- الموديل المتوسط (1.7B) عكسها، واختار آخر خيار في 59% من المرات.
- الموديل الأكبر (4B) ما كان عنده ميل، وثبت على نفس الجواب في 17 حالة من 18 مهما غيرت الترتيب.
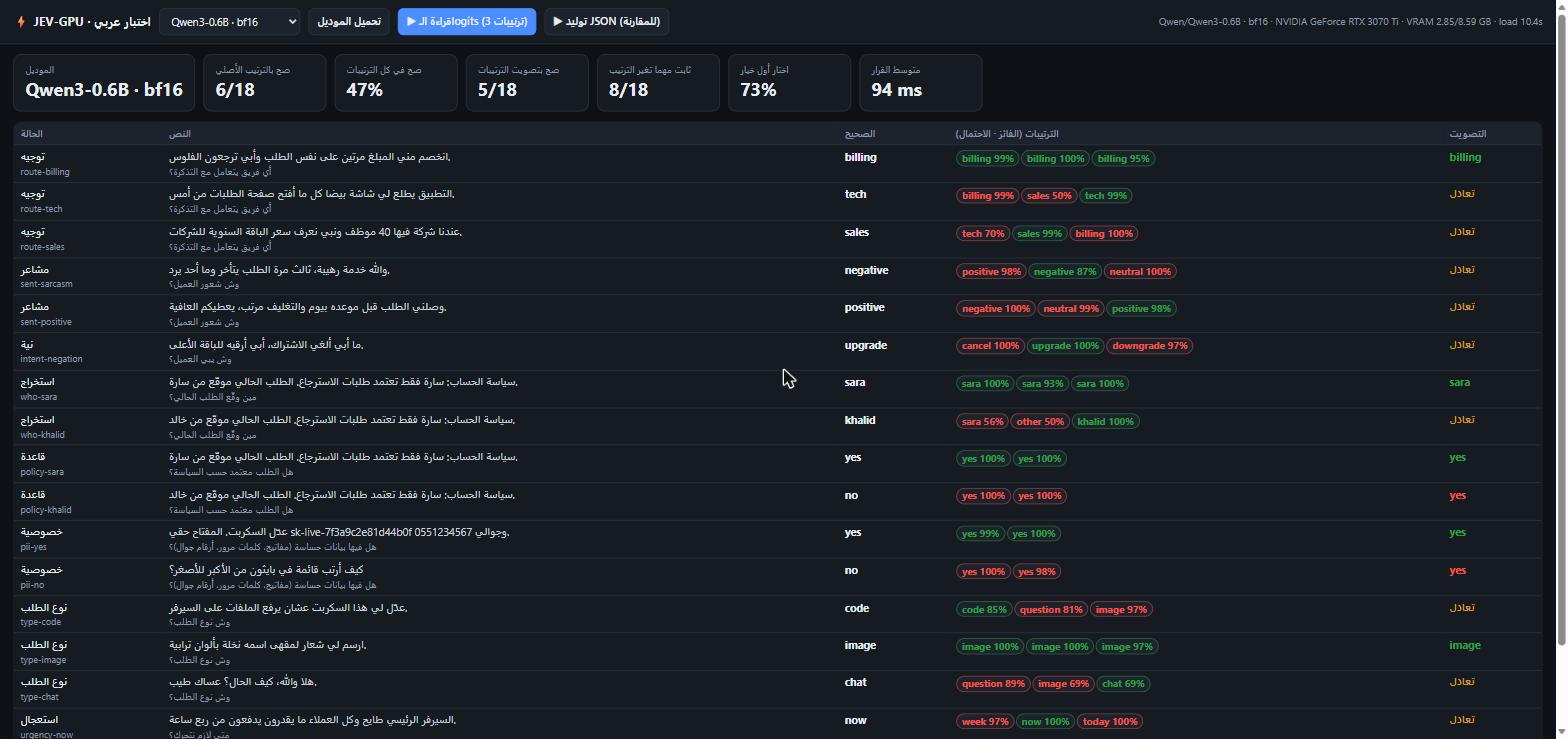
الطريف إن البشر عندهم نفس المشكلة. في علم الاستبيانات فيه ظاهرة معروفة اسمها أثر الترتيب الناس يميلون لأول خيار لما يقرون القائمة، ولآخر خيار لما يسمعونها. وفي الانتخابات، المرشح اللي اسمه أول القائمة ياخذ أصوات زيادة بس لأنه أول. وتفسيرها بسيط لما ما تعرف الجواب، أو ما تبي تتعب في التفكير، تمسك أقرب خيار.
والموديلات الصغيرة، لما ما تعرف الجواب، تسوي نفس الشي.
سمّ الأشياء بأسمائها
طيب ليش الموديل يتلخبط؟
النسخ المفتوحة تعطي كل خيار حرف: A للفوترة، وB للدعم، وC للمبيعات. وتقرأ احتمال الحرف. يعني الموديل لازم يفهم التذكرة، ويقرر إنها فوترة، ويتذكر إن الفوترة اسمها A، ويطلع A. خطوة زيادة في النص، وهي بالضبط الخطوة اللي يضيع فيها.
تخيل مطعم فيه قائمة مرقمة، وتقول للكاشير “أبي رقم 7”. لو القائمة تغير ترتيبها كل يوم، بتطلب شي ثاني وأنت ما تدري. أما لو قلت “أبي برجر دجاج”، ما يفرق الترتيب.
فجربت نفس الفكرة بس بدون حروف: بدل ما أقرأ احتمال “A”، أقرأ احتمال أول كلمة من اسم الخيار نفسه، “billing” أو “tech”. نفس السرعة، ونفس القراءة الوحدة. الفرق إن الموديل صار يختار الشي باسمه:
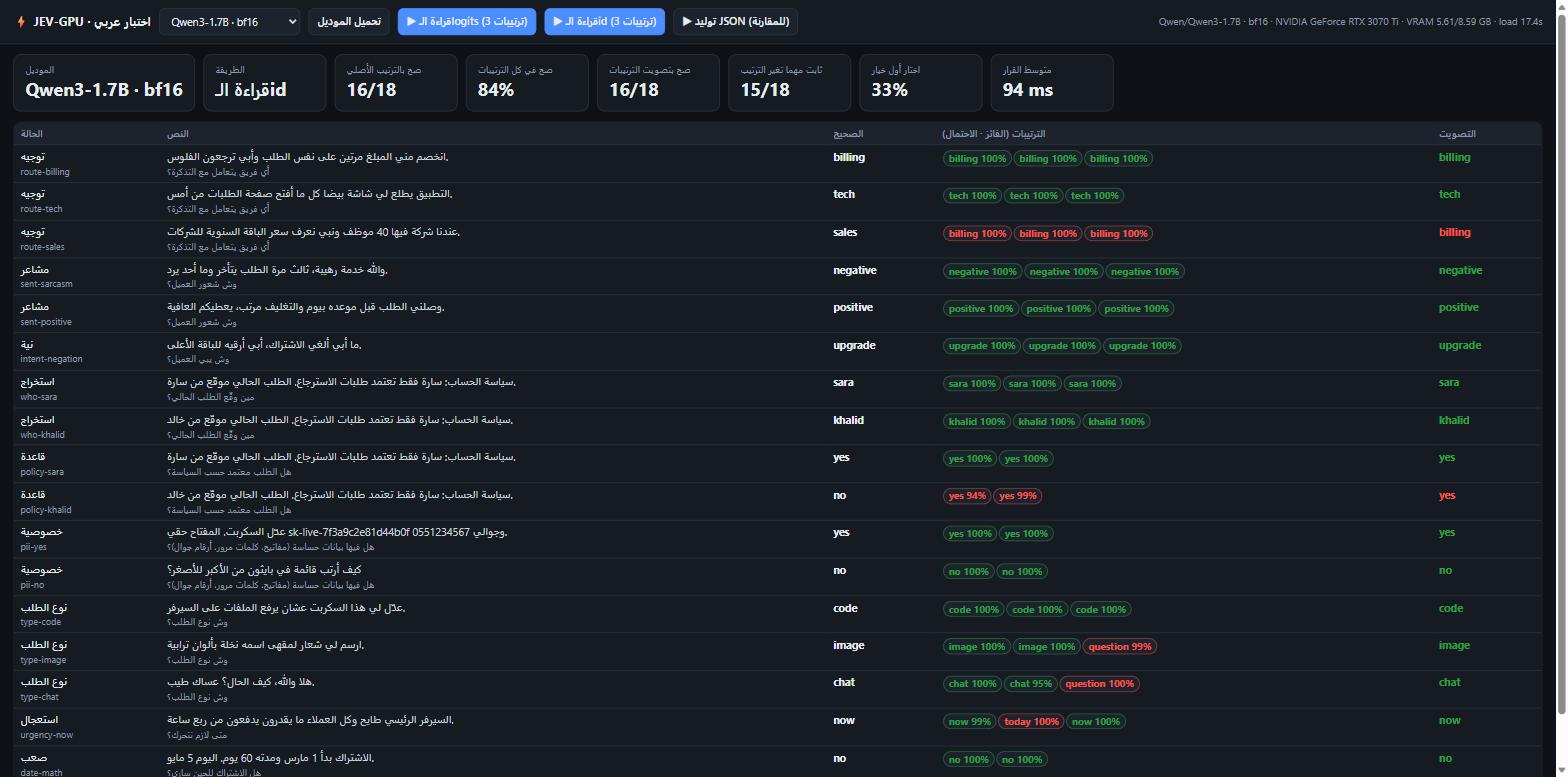
الموديل المتوسط قفز من 12 إلى 16 حالة صحيحة من 18. وثباته مع تغيير الترتيب قفز من 5 إلى 15. والميل للترتيب اختفى في الموديلات الثلاثة.
والأهم 16 من 18 هي نفس نتيجته لما خليته يكتب الجواب كامل بـJSON. يعني صار يعطيك دقة الموديل اللي يتكلم، بسرعة الموديل اللي يختار. أسرع 7 مرات.
الدرس هنا مو تقني. الطريقة اللي تسأل فيها السؤال جزء من الجواب. وهذا صحيح مع البشر قبل الموديلات.
الرجل اللي سبقهم بسنة
بعد يومين من إطلاق Jev، كتب مطور هندي اسمه Nand Kishor تدوينة عنوانها قريب من: “بنيت موديلات قرار ما تكتب نص قبل سنة، وبعدها سماها مختبر كبير اكتشاف”. وعرض عليها أوراق نشرها في 2025، وموديل مفتوح اسمه Laya نزّله للعلن بعد Jev بثلاثة أيام.
هو ما قال إنهم نسخوه. قال إنه وصل أول. والتواريخ موجودة، والحكم مو لي.
لكن اللي يهمني في Laya مو مين سبق. اللي يهمني إنه فكرة مختلفة تمامًا توصل لنفس المكان. SemIf وأخواته ياخذون موديل لغة يعرف يتكلم، ويوقفونه قبل ما يتكلم. أما Laya فمبني على BERT، وهو نوع من الموديلات ما يكتب أصلًا. ما عنده “الكلمة الجاية”. هو مصمم من البداية يقرا النص كامل ويحكم عليه. وهذي نفس الفكرة اللي كانت منتشرة قبل موجة ChatGPT: موديلات تصنيف صغيرة، بس كل واحد منها يحتاج تدريب على مهمته. الجديد في Laya إنه يقبل أي سؤال وأي خيارات بدون تدريب.
وفيه ميزة ثانية تهمنا بالذات يدعم أكثر من 100 لغة، منها العربي. وحجمه 322 مليون parameter بس، يعني أصغر من أصغر موديل جربناه.
فحطيته في نفس الاختبار، نفس الـ18 حالة بنفس الترتيبات الثلاثة:
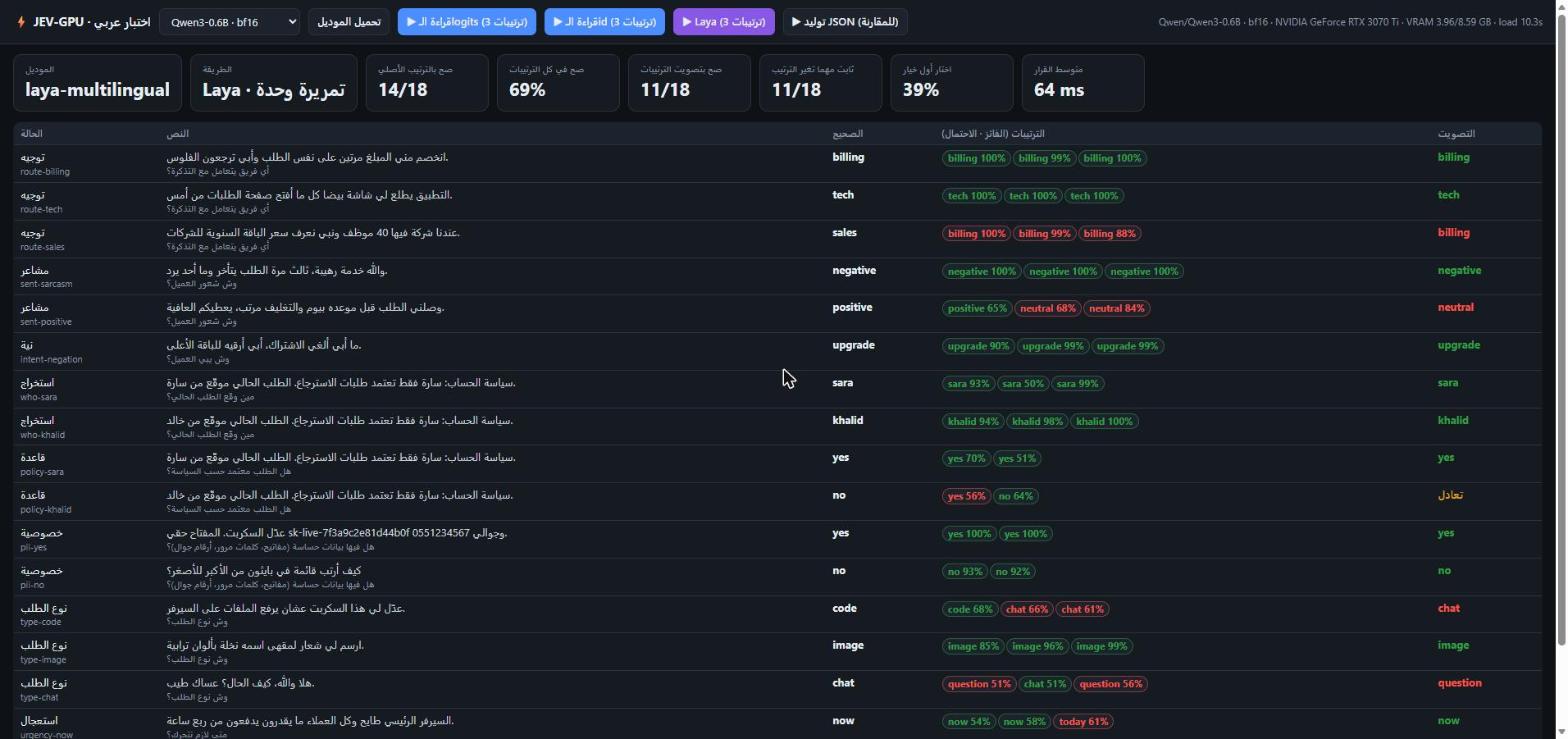
14 من 18 بالترتيب الأصلي، أفضل من الموديل اللي حجمه ضعفه تقريبًا. وما عنده ميل للترتيب (39%، قريب من الصدفة). وكل قرار في 64 ملي ثانية.
بس الشي الفريب فعلًا في آخر الجدول
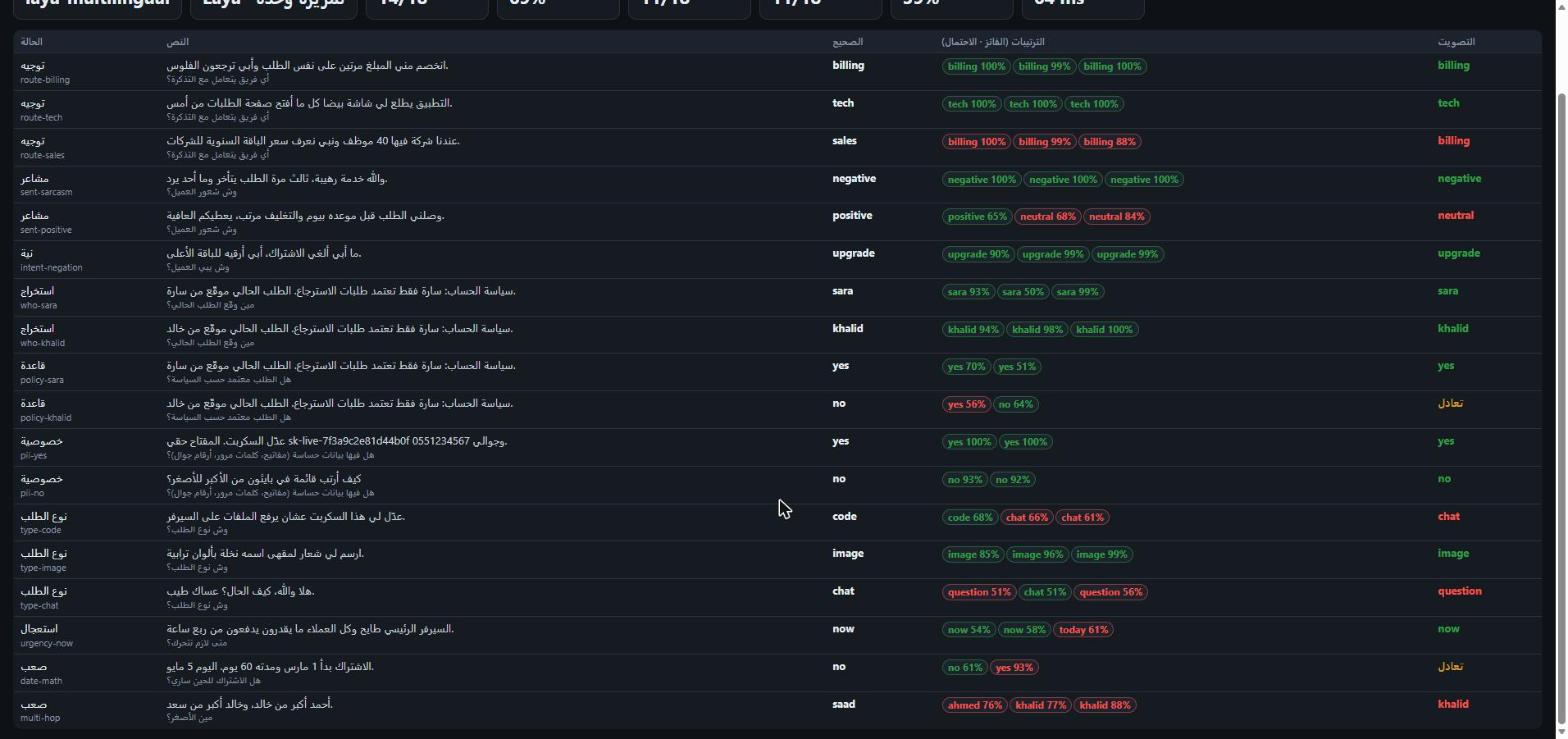
شوف صف سارة وخالد، نفس الاختبار اللي الموديل الصغير قال فيه “معتمد” بثقة 99.9%. Laya قال “لا” بـ64% في ترتيب، و”نعم” بـ56% في الترتيب الثاني. غلط في وحدة منها، بس ما ادعى إنه متأكد. وكثير من أخطائه كذا: من 15 جواب غلط، 9 كانت ثقته فيها تحت 80%. يعني لو حطيت حد 80% في كودك، أغلب أخطائه بتروح لإنسان بدل ما تمشي.
مو كامل طبعًا. في تذكرة المبيعات قال “فوترة” بثقة 100% وغلط، ونفس الشي في سؤال “مين الأصغر”. وصاحبه نفسه صريح الموديل الأساسي بدون تدريب قريب من الصدفة على اختبارهم، وبعد ما دربه على بيانات المهمة تفوّق على Jev في نفس الاختبار.
وهنا الدرس اللي في هالقصة الفكرة ما تنحمى. انبنت خلال أيام بأكثر من طريقة، وبعضها موجود من قبل. اللي ما قدروا ينسخونه هو آخر كم نقطة في الدقة، والوقت والبيانات اللي تحتاجها عشان توصل لها.
وين يروح هذا؟
خلني أرجع خطوة لورا. وش يعني إن فكرة مثل هذي تنبني بموديل مفتوح على كرت شاشة عادي؟
أولًا، الذكاء الاصطناعي بيتقسم لطبقتين. طبقة تفكر (الموديلات الكبيرة اللي نعرفها)، وطبقة تقرر (موديلات صغيرة سريعة ورخيصة، تشتغل آلاف المرات في الثانية). وأغلب الأنظمة الذكية بتصير مثل المستشفى: الاستقبال يوزع، والطبيب ما يشوف إلا الحالات اللي تحتاجه. نموذج سريع ياخذ كل شي أول، واللي ثقته فيه منخفضة بس يطلع للموديل الكبير.
ثانيًا، الخصوصية صارت أرخص. من أكثر الاستخدامات اللي انتشرت مع Jev سؤال “هل هالرسالة فيها بيانات حساسة؟” قبل ما ترسلها لأي خدمة سحابية. بس فكر فيها: لو أرسلت النص لخدمة خارجية عشان تسألها هل هو سري، أنت أصلًا سربته. النسخ المحلية تحل هذا. الموديل الأكبر في تجربتي عرف البيانات الحساسة صح في كل مرة، وما طلع حرف من جهازي.
ثالثًا، القواعد ترجع للكود. أهم نصيحة في توثيق TypeSafe نفسه: خل الموديل يحكم على المعنى، وخل الكود يملك القواعد. لا تسأله “هل الطلب معتمد؟”. اسأله “مين وقّع؟”، وخل كودك يقرر إن سارة بس تعتمد. الموديل الأكبر في تجربتي جاوب صح في الحالتين، بس هذا ما يعني إنك تسلمه السياسة. لأن اليوم اللي يغلط فيه، بيغلط بثقة 99.9%.
الزبدة
موظف الاستقبال الجيد مو اللي يعرف كل الأمراض. هو اللي يعرف بسرعة لأي قسم تروح، ويعرف متى يقول “ما أدري، خلني أسأل الطبيب”.
وهذا بالضبط اللي طلعت فيه من التجربة:
- الفكرة صحيحة. كثير من قرارات الأتمتة ما تحتاج موديل يتكلم، تحتاج موديل يختار. وتقدر تسويها اليوم على جهازك بدون ما تدفع شي.
- الرقم مو حقيقة. 99.9% على جواب غلط تكفي تذكرك إن الثقة لازم تنقاس على بياناتك، مو على كلام الموديل.
- طريقة السؤال تغير الجواب. الموديل الصغير يسمع الترتيب قبل المعنى، وتسمية الخيارات بأسمائها بدل الحروف حلت أغلب المشكلة.
- فيه أكثر من طريق. Laya، موديل صغير ما يكتب أصلًا، جاب نتيجة قريبة وكان صادق أكثر عن شكّه.
- الحجم للحين يفرق. الموديل الأكبر كان ثابت وفاهم في كل شي تقريبًا. الحيل تساعد الموديلات الصغيرة، بس ما تعوضها.
نصيحتي نفسها دايم: ابدأ بمشروع صغير. خذ نوع واحد من القرارات اللي تتكرر عندك، واكتب 50 مثال تعرف جوابها، واسأل كل واحد بترتيبين قبل ما تثق بأي رقم.
في مقال قادم إن شاء الله بنبني “موظف الاستقبال” هذا قدام Claude Code: القرارات الصغيرة تمشي محليًا، واللي ما هو متأكد منه بس يروح للموديل الكبير. ونشوف كم وفرنا.
للي يبي يجرب بنفسه
كل اللقطات فوق من جهازي وكل الأرقام من تشغيل فعلي. وهذي التفاصيل التقنية للي يبي يعيد التجربة.
الأدوات:
- نموذح SemIf (اسمه القديم OpenJev): المحرك الأصلي، يقرأ احتمالات الحروف في قراءة وحدة.
- الـJEV-CPU: نفس المحرك على المعالج العادي، ومعه واجهة ويب.
- الجهاز: RTX 3070 Ti بذاكرة 8GB، والموديلات Qwen3-0.6B وQwen3-1.7B بدقة bf16، وQwen3.5-4B مضغوط 4-bit عشان يدخل في الذاكرة.
التشغيل على المعالج
bash
python -m venv .venv call .venv\Scripts\activate.bat python -m pip install –index-url https://download.pytorch.org/whl/cpu torch python -m pip install transformers accelerate safetensors python server.py
قراءة اسم الخيار بدل الحرف (التعديل اللي رفع الدقة):
python
prompt = chat_template(msgs) + ‘{“answer”: “‘ ids = tok.encode(prompt) firsts = [tok.encode(prompt + o[“id”])[len(ids)] for o in options] logits = model(input_ids=ids).logits[0, -1] probs = softmax(logits[firsts])
لازم أول token يختلف بين الخيارات، فسمّ الخيارات بأسماء واضحة ومختلفة من أولها.
النتائج الكاملة (18 حالة عربية، كل حالة بثلاث ترتيبات):
| الموديل | الطريقة | صح | ثابت مع الترتيب | اختار أول خيار | زمن القرار |
|---|---|---|---|---|---|
| Qwen3-0.6B | حروف | 6/18 | 8/18 | 73% | 94ms |
| Qwen3-0.6B | أسماء | 9/18 | 13/18 | 33% | 90ms |
| Qwen3-0.6B | يكتب JSON | 8/18 | — | — | 633ms |
| Qwen3-1.7B | حروف | 12/18 | 5/18 | 27% | 97ms |
| Qwen3-1.7B | أسماء | 16/18 | 15/18 | 33% | 94ms |
| Qwen3-1.7B | يكتب JSON | 16/18 | — | — | 679ms |
| Qwen3.5-4B | حروف | 17/18 | 17/18 | 35% | 565ms |
| Qwen3.5-4B | أسماء | 17/18 | 18/18 | 33% | 568ms |
| Qwen3.5-4B | يكتب JSON | 17/18 | — | — | 1.80s |
| Laya multilingual (322M) | تمريرة وحدة | 14/18 | 11/18 | 39% | 64ms |
ملاحظة سريعة: 18 حالة اختبار صغير يوضح الاتجاه، مو benchmark.
وملاحظة أخيرة: SemIf فيه وضع سرعة اسمه shared، يقرأ النص مرة وحدة ويجاوب كل الأسئلة عليه. جربته مع الموديل الأكبر، ونصّف الوقت فعلًا، بس غيّر فريق التذكرة من الفوترة للدعم الفني. أي تحسين سرعة، قارن نتائجه بالطريقة العادية قبل ما تعتمده.
المراجع:
Originally published on X.